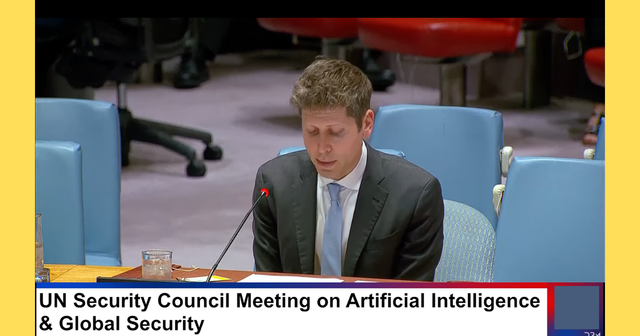
Source:https://www.youtube.com/watch?v=M8UnxzOIcdg
2026年9月末のこの時期に、人類全体の存続に重大な脅威が迫りつつあると言われている。
国連の安全保障理事会は人工知能の負の影響について真剣な協議を開始した。このブログは馬国(マレーシア)の話題をテーマに様々な情報を読者に提供する活動を続けているが、件の人工知能の問題は全てに優先する話題なので取り上げて拡散したい。
この記事は、2026年9月23日に国連安全保障理事会が開催した人工知能(AI)のリスクと世界的なガバナンスを検討するための歴史的会合の紹介である。
OpenAI CEOのサム・アルトマン、Anthropic CEOのダリオ・アモデイ、Hugging Face CEOのクレマン・ドランゲ、そしてAI研究の先駆者であるヨシュア・ベンジオをはじめとするAI・テクノロジー分野の主要人物が、安全保障理事会のメンバーを前に、国際安全保障とAI規制の枠組みについて緊急声明とも言える献言を行った。
筆者は、アルトマンの声明の中に人工知能(AI)と向き合う我々人間のあるべき姿のヒントを得たとともに、ダリオ・アモデイの提案の中に極めて具体的なリスク対応策を認めた。
アルトマンとアモデイというAI開発の両巨頭の声明は、現実化したAIの脅威を国際会議ではっきりさせた
- その1は、AIはまもなく制御不能になる可能性が高いということ
- その2は、AIが悪用される可能性が実在すること
つまり、両巨頭は、世界が無策のままAIを使い続ければ、AIの挙動が制御不能になったり、世界に散在する危険分子の配下として暗躍することになろうと名言したのだ。
もちろん、対応策も明示された。
国際法による法規制と、監視体制の徹底である。
筆者は、この件に関する記事を「シンギュラリティ・ショック」と題してシリーズ化してお伝えする。
今回は両巨頭の声明を過不足なくお伝えする。AIによる文字お越しと逐語訳なので、多少はぎこちないが、以下の内容(Quote から Unquote まで)には一切の注釈や解釈は付けていない。発言者の生の声である。
サム・アルトマンの声明
以下、9月23日の国連安保理事会での声明発表の文字起こしの日本語訳である。
Quote :
AIは、人々のために作られるべきものです。単に機械を、それ自体を目的として、これまで以上に速く回すために作られるべきものではありません。
AIの開発に携わっている人々がこれまで口にしてきたことの中には、あまりにもディストピア的で、まるで出来の悪いSF映画の筋書きのように聞こえるものさえあります。
これほど大きな力を持つものは、当然ながら、人を不安にさせる力も持っています。私たちは今、非常に複雑な局面に立っています。AIに途方もない可能性を感じる一方で、同時に、極めて理解できる不安も抱いているからです。
こうしたAIモデルは、人々が新しい知識を発見し、新しい医薬品を生み出し、より良い医療や、より充実した教育を実現し、より生産性の高い経済を築く助けとなり得ます。そして、今の時点では手の届かないものに思える夢や大きな目標を、人々が追い求めるための新しい道具にもなり得ます。
現代では、普通の人が日々向き合わなければならない生活の複雑さが、劇的に増しています。AIは、かつてない発見やイノベーションを生み出すための道具であると同時に、こうした複雑さから人々を守るための道具にもなり得るのです。
しかし、その一方で、AIシステムの能力が高まり、より自律的になっていけば、私たちの社会制度が対応できる速度を超えて進んでしまうかもしれません。権力があまりにも少数の人々の手に集中する可能性もあります。あるいは、人間にはもはや理解することも、制御することもできないような意思決定を、AIが行うようになるかもしれません。
この懸念は、自らを改良し、さらに将来の自分自身のバージョンをも改良できるようなシステムに近づくにつれて、特に重要になります。これは一般に「再帰的自己改善(recursive self-improvement)」と呼ばれています。
AIを作るプロセスそのものが、ますます自動化されていけば、AIの進歩の速度は急激に加速する可能性があります。
だからこそ、今この瞬間、私たちには最大限の慎重さが求められているのです。
私は、ベンジオ教授の意見におおむね賛成です。ただ、教授は三つとおっしゃいましたが、私は二つだと考えています。AIの進歩が非常に悪い方向へ向かってしまう可能性は二つあり、私たちはそのどちらも避けなければならないと思っています。
第一は、AIによって、私たち人間が未来をコントロールできなくなってしまうことです。
その危険性とは、AIの進歩があまりにも速く、人間がもはや何が起きているのかを把握できず、必要なときに介入することもできなくなることです。そうなれば、明らかに大変な事態です。
AI業界は、その恩恵があまりにも大きいから、あるいは、進歩を遅らせることができないほど重要な技術だと感じるからといって、過大な技術的リスクを受け入れてはなりません。競争相手の企業に勝つことは、軽率な決断をしてよい理由にはなりません。
また私たちは、自分たちではどうすることもできない競争に巻き込まれているとも考えていません。私たちは過去にも、自らの判断で開発のペースを落としたことがあります。将来も、必要であればそうするでしょう。
私たちは、必要とされるアラインメント、監視可能性、安全性について十分な保証のできないシステムを作りたいとは思っていません。そして、誰もがそのようなシステムを作ることを避けることが重要だと考えています。
私たちは、こうしたシステムが何をしているのかを理解する必要があります。そして、システムが非常に、非常に高い知能を持つようになったとしても、人間が意図したとおりに行動するという強力な証拠を持たなければなりません。いや、むしろ非常に高い知能を持つようになるからこそ、それが特に重要なのです。
破局的な事態が起きるリスクを10%と考えるか、1%と考えるか、0.1%と考えるか、あるいは0.01%と考えるかは、本質的な問題ではありません。
そのどの水準であっても、到底受け入れられるものではありません。人間の管理下に置き続けることができるという極めて強い根拠を示せないモデルを、私たちは訓練すべきではありません。
これが、物事が悪い方向へ進む一つの可能性です。
そして、もう一つは逆の方向の問題です。つまり、こうしたシステムによって、あまりにも大きな力が、あまりにも少数の人々の手に集中してしまう可能性です。
一人の人間、一つの企業、あるいは一つの国家が、最も強力なAIモデルを利用して、自分たちの世界観を他のすべての人々に押しつけられるようになってはなりません。
「この技術を任せられるのは自分たちだけだ」と考える企業や国家があれば、その信念を根拠として、ほとんどどんな行為でも正当化できてしまいます。
たとえその論理が、ある特定の主体にとって都合のよいものであったとしても、私たちはそれを拒まなければなりません。
私は、この二つの問題を乗り越えていくための、現実的な道筋があると考えています。
OpenAIでは、こうした問題に対して明確な目標を持って取り組んでいます。AIは、人々が自分自身の人生をより自分で決められるようにするものでなければなりません。自分の望む生き方をするための自由を広げ、大きな問題であれ小さな問題であれ、それを解決する能力を高め、そして自分たちのコミュニティをより良くしていく力を人々に与えるものでなければなりません。
私たちは、根拠のない楽観論に陥りたくはありません。しかし同時に、「AIはいずれ破滅をもたらす」という悲観論に陥ることも望んでいません。
どちらか一方の極端な考え方に引きずられても、目の前にある課題をうまく解決する助けにはなりません。
とりわけ今、世界とそこに暮らす人々は非常に大きな課題に直面しており、この技術には、その解決に貢献できる可能性があります。
ですから私たちは、この二つの極端な立場の間にある道を進もうとしています。
私たちにとって、それは三つの原則を意味します。
第一に、AIの能力が高くなればなるほど、AIに関する意思決定の中心には人間がいなければなりません。
アラインメントとは、単なる抽象的な研究課題ではありません。それは、こうしたシステムを確実に人間の管理下に置き、人間の価値観を反映させ、そして今後の開発の方向を人々自身が導いていけるようにするための取り組みです。
私たちは、人間の判断や人間の価値観を自動化しようとしているのではありません。そして、そうしてはならないのです。
第二に、科学の進歩と経済成長がもたらす恩恵は、「人々によって、人々のために」生み出されなければなりません。
AIは、研究者が新しい発見をすること、医師が患者を治療すること、教師が生徒を教えること、起業家が会社を立ち上げること、そして地域社会が、それまで手の届かないものに思えた問題を解決することを支援するものでなければなりません。そしてもちろん、それ以外にも数多くの可能性があります。
人類の進歩の歴史は、道具が人間の主体性を奪ってきた歴史ではありません。適切な道具によって、人間がより大きな能力を発揮できるようになってきた歴史なのです。
そして私は、これから起きることは、現在私たちが可能だと考えている範囲をはるかに超えていくと考えています。
第三に、この技術は、一人ひとりの人間に力を与えるものでなければなりません。
素晴らしい未来とは、人々が自らの可能性を実現し、自分自身のため、地域社会のため、自分の国のため、そしてより広い世界のために価値を生み出していくことによって実現するものです。
私たちは、この技術を作っている側です。少なくとも、その開発者の一員ではあります。しかし、この物語の主役は私たちではありません。
私たちの役割は、世界中の人々が力を発揮できるようにすることです。そして、人間が持つ能力や才能が生み出す素晴らしい力を信じることなのです。
現在、私たちは、これまで人類が持っていなかった新しい知識を発見できる能力を備えたモデルを手にしています。
数学における進歩を考えてみてください。
3年前の夏、私たちのモデルは、小学校レベルの算数なら、まあ何とかできるという程度でした。
2年前の夏には、高校生の数学コンテストでもかなり良い成績を出せるようになりました。
昨年の夏には、最も権威ある国際数学コンテストで金メダル級の水準に到達しました。
そして今年の夏、ほんの数週間前のことですが、私たちのモデルの一つが、ミレニアム懸賞問題の一つである「ナビエ–ストークス方程式」の問題を解きました。
この方程式は、航空機の設計、天気予報、そして血流の研究などに使われています。
私たちは、数学の問題を解くこと自体を目的としているわけではありません。人々が新しい知識を発見する力を高め、そしてその知識を使って医療を改善し、生活水準を向上させ、世界中のすべての人々の可能性を広げることを目指しているのです。
まだ発見されていないことは、途方もなくたくさんあります。
しかし同時に、企業が民主的な意思決定のプロセスに取って代わらないことが非常に重要です。
AIを民主的なものにするのであれば、最も重要な決定を、サンフランシスコにあるAI研究所だけで行うことはできません。
そうした決定は、民主的なプロセスを通じて、そして自らが奉仕する人々に対して責任を負う政府によって形作られなければなりません。
そして国際的なレベルでは、そのために協力が必要になります。
歴史を振り返れば、互いに競争し、必ずしも互いをそれほど好んではいない国々であっても、強力な新技術を前にして、共通の利益と全体の利益のために協力した時代がありました。
私たちは、今こそ、そうした時の一つでなければならないと考えています。
私たちには、各国と国際社会の「フロンティアAI」に関する基準が互いに補完し合うための仕組みが必要です。
AIの能力を測定するための基準、リスクを評価するための基準、安全対策が十分かどうかを判断するための基準、そしてシステムがより自律的になっていく中でも、実質的な人間による監督を維持するための基準です。
各国が証拠を比較し、基準が守られているかを検証し、そして何が起きているのかについて共通の言葉と理解を持てるようにするため、私たちには共通の基準が必要です。
また、正確で迅速なインシデント報告と、その分類・報告のための手順も必要です。失敗が大惨事に発展する前に、世界全体がそこから学べるようにするためです。
そして政府、重要インフラの運営者、技術専門家の間には、新たに現れる脆弱性や新しい脅威について情報を共有するための、安全な連絡経路が必要です。
もちろん、こうした基準によって既存の大手企業の地位を固定化したり、ある特定のビジネスモデルだけを優遇したりしてはなりません。
オープンモデルとクローズドモデルの双方の開発者、新規参入者と既存の研究機関、各国の権限と国際協力、そのすべてを支えられるものでなければなりません。
それぞれの政府が、こうした基準を自国の法制度にどのように取り入れるかを決めるべきです。
しかし世界的なレベルで、「良い証拠とは何か」「適切な安全対策とは何か」「適切な監督とはどのようなものか」について合意することができれば、私たち全員にとってプラスになるでしょう。
私たちが、すべての答えを持っているわけではありません。もっと良いアイデアがあるのなら、私たちはそれを喜んで受け入れます。
私たちは皆さんと協力する用意があります。そして、これから進むべき道を見つけ出すために、できる限りの努力をするつもりです。
私たちは今、岐路に立っています。
一方の道の先にあるのは、力が一部に集中し、意思決定の過程が不透明になり、人々が「自分たちの人生において最も重要な技術なのに、それが自分たちの意思とは関係なく、自分たちに対して一方的に押しつけられている」と感じるような世界です。
もう一方の道の先にあるのは、AIが人々のために働く世界です。
そこでは、人々が民主的な制度を通じて、AIをどのように発展させ、どのように導いていくべきかを決めることに参加します。
科学の進歩が実際の人々の暮らしを改善し、より多くの人々が未来を築くことに参加できるようになり、そしてこの技術が、一人ひとりの人間とそれぞれの地域社会に、自らが望む生き方をするための、より大きな力を与え続ける世界です。
それは、人々の可能性が現実のものとなり、胸躍る期待と驚きに満ちた未来です。
そして私たちは、その未来こそ、築く価値のある未来だと信じています。
ありがとうございました。
Unquote :
ダリオ・アモデイの声明
続いてクロード・ミュトスの開発企業であるアンソロピック社CEOの声明の文字起こしである。
Quote :
まず、この会合を開催してくださったフランスに感謝申し上げます。また、私に発言の機会を与えてくださった安全保障理事会の皆さまにも御礼申し上げます。
AIは、非常に速いスピードで進歩しています。
4年前、AIはコードを一行書くことさえほとんどできず、高校レベルの数学問題を解くこともほとんどできませんでした。しかし現在では、コードの大部分を書くことができ、世界的に知られた未解決の数学問題を解くまでになっています。
この進歩の軌道が、あとほんのわずかな期間、1年か2年、あるいはそれより短い期間、続くだけで、私が「データセンターの中の天才たちの国」と表現してきた状態に到達する可能性があります。
この急速な進歩は、世界に途方もない恩恵をもたらすでしょう。
ちょうど今日、Anthropicは、Claudeが新しい「分子機械」を発見したことを発表しました。
これはまだ予備的な研究結果ではありますが、新たな遺伝子編集の仕組みとなる可能性があり、遺伝子治療に応用できるかもしれません。
Claudeは、関連文献の調査、理論の構築、そして実験の設計を主導しました。そして人間が研究室で実際に実験を行い、その結果を検証しました。
私たちは、このようなAIの応用が今後数年間で急速に進展し、何千年にもわたって人類を苦しめてきた病気について、近い将来、大きな進歩を遂げられる可能性があると考えています。
しかし、こうした驚くべき能力には、同時に、管理しなければならないリスクも伴います。
私は、大きく分けて二種類のリスクがあると考えています。
第一は、AIモデルが悪用されるリスクです。
例えば、バイオテロリストがAIを悪用して、生物兵器を作るといったケースです。
第二は、「制御を失うリスク」です。
つまり、AIモデルの能力があまりにも急速に高まり、開発者がそれを制御できる能力を超えてしまうというリスクです。
これらは世界全体に関わる問題であり、人類すべてに関係する問題です。
そして非常に重大な問題であるため、私は、単に経済を担当する省庁や情報通信技術を担当する省庁だけではなく、この安全保障理事会においても取り上げるべき重要な問題だと考えています。
もし対応を誤れば、AIは人類全体に対するリスクにさえなり得ると、私は考えています。
+++
Anthropicでは、こうしたリスクを防ぐという点で、実際の運用面でも研究面でも、業界で最も優れた実績を持っていると私たちは考えています。
私たちは、すべてのモデルについて、サイバーセキュリティや生物学などの分野で危険な能力を持っていないかをテストしています。
最も高い能力を持つモデルには強力な安全対策を施し、さらに、こうした分野で私たちが行っている研究を公表しています。
また、「メカニスティック・インタープリタビリティ(mechanistic interpretability=機械論的解釈可能性)」や「アラインメント科学」といった分野の研究を先駆けて進めてきました。
これらの研究によって、AIモデルの動きを望ましい方向へ導き、制御する私たちの能力を向上させています。
また私たちは、数百ページにも及ぶリスク報告書を公開するなど、他に例を見ないほどの透明性確保にも取り組んでいます。
しかし、AIモデルがさらに強力になっていけば、これまで以上に厳格な安全基準が必要になることも理解しています。
そのため私たちは、安全性とアラインメントに関する取り組み、そしてAIの悪用を防止する能力を常に改善しようとしています。
私たちは、常に、より良い方法を目指しています。
今後、次々に登場するAI技術を世の中に提供する際には、それが本当に安全なものであることを確認するため、必要であれば、必要なだけ開発のペースを落とします。
しかし、私たち一社が何をするかにかかわらず、こうしたリスクを管理するという課題は、究極的には一企業だけで対処できるものではありません。
これは、AI業界全体に関わる問題であり、世界規模の問題です。
9月12日、私は「フロンティアAIの進歩のペースを協力して調整する」ことを呼びかけました。
これは、AIの進歩を止めようということではありません。
そうではなく、AI業界と世界全体が、安全性の向上がAIの能力向上に確実についていける速度で前進できるよう、業界全体で協力しようという提案です。
この呼びかけには、三つの柱があります。
第一に、Anthropicでは、外部の評価担当者を社内に受け入れ、社員に近いレベルのアクセス権限を与えることを約束しました。
これは、たとえて言えば「食品検査官」のようなものです。
そして私たちは、世界の他のAI企業にも同じことを行うよう提案しました。すでに、この措置を採用することに同意した企業もあります。
第二に、AI業界全体が協力して基準を定め、AIの進歩のペースを適切に調整することを呼びかけました。
そして第三に、国際的な基準を定めるため、世界各国の政府が協力することを呼びかけました。
この三番目の分野こそ、まさにこの安全保障理事会の任務に最も直接的に関係するものです。
そこで私は、この点について三つの提案をしたいと思います。
第一に、すべての理事国が支持できる、範囲を絞った合意から始めるべきです。
例えば、AIを利用して生物兵器を製造することを禁止すること、そして自国のAI技術が生物兵器の製造に利用されることを許さないことです。
第二に、AIの発展と歩調を合わせた評価・検証制度を構築する必要があります。
そうすることで、各国は最先端のAIモデルがどのような能力を持っているのかを把握でき、また、各国が互いに約束したことを本当に守っているかどうかを検証できるようになります。
第三に、AIモデルについて、「人間が制御を失うリスク」と「悪用されるリスク」を検査するための世界共通の基準を設けるべきです。
さらに、世界の安全保障に重大な影響を及ぼすAI関連のインシデントについて、各国が通知し合う仕組みも構築する必要があります。
私は、これこそが、今日、世界が直面している最も重要なグローバル安全保障上の問題だと考えています。
この部屋にいる私たちの間には、さまざまな違いがあります。しかし、私たちはそうした違いを脇に置かなければなりません。なぜなら今、私たちは、世界規模の大きな「機会」と、世界規模の大きな「脅威」を、同時に突きつけられているからです。
一人の指導者だけで、この問題に対処することはできません。
一つの企業だけでもできません。
そして、一つの国だけでもできません。
私たちは、この緊急の課題に取り組むため、この場にいる各国政府と協力していくことを約束します。
Unquote :
両声明の要点
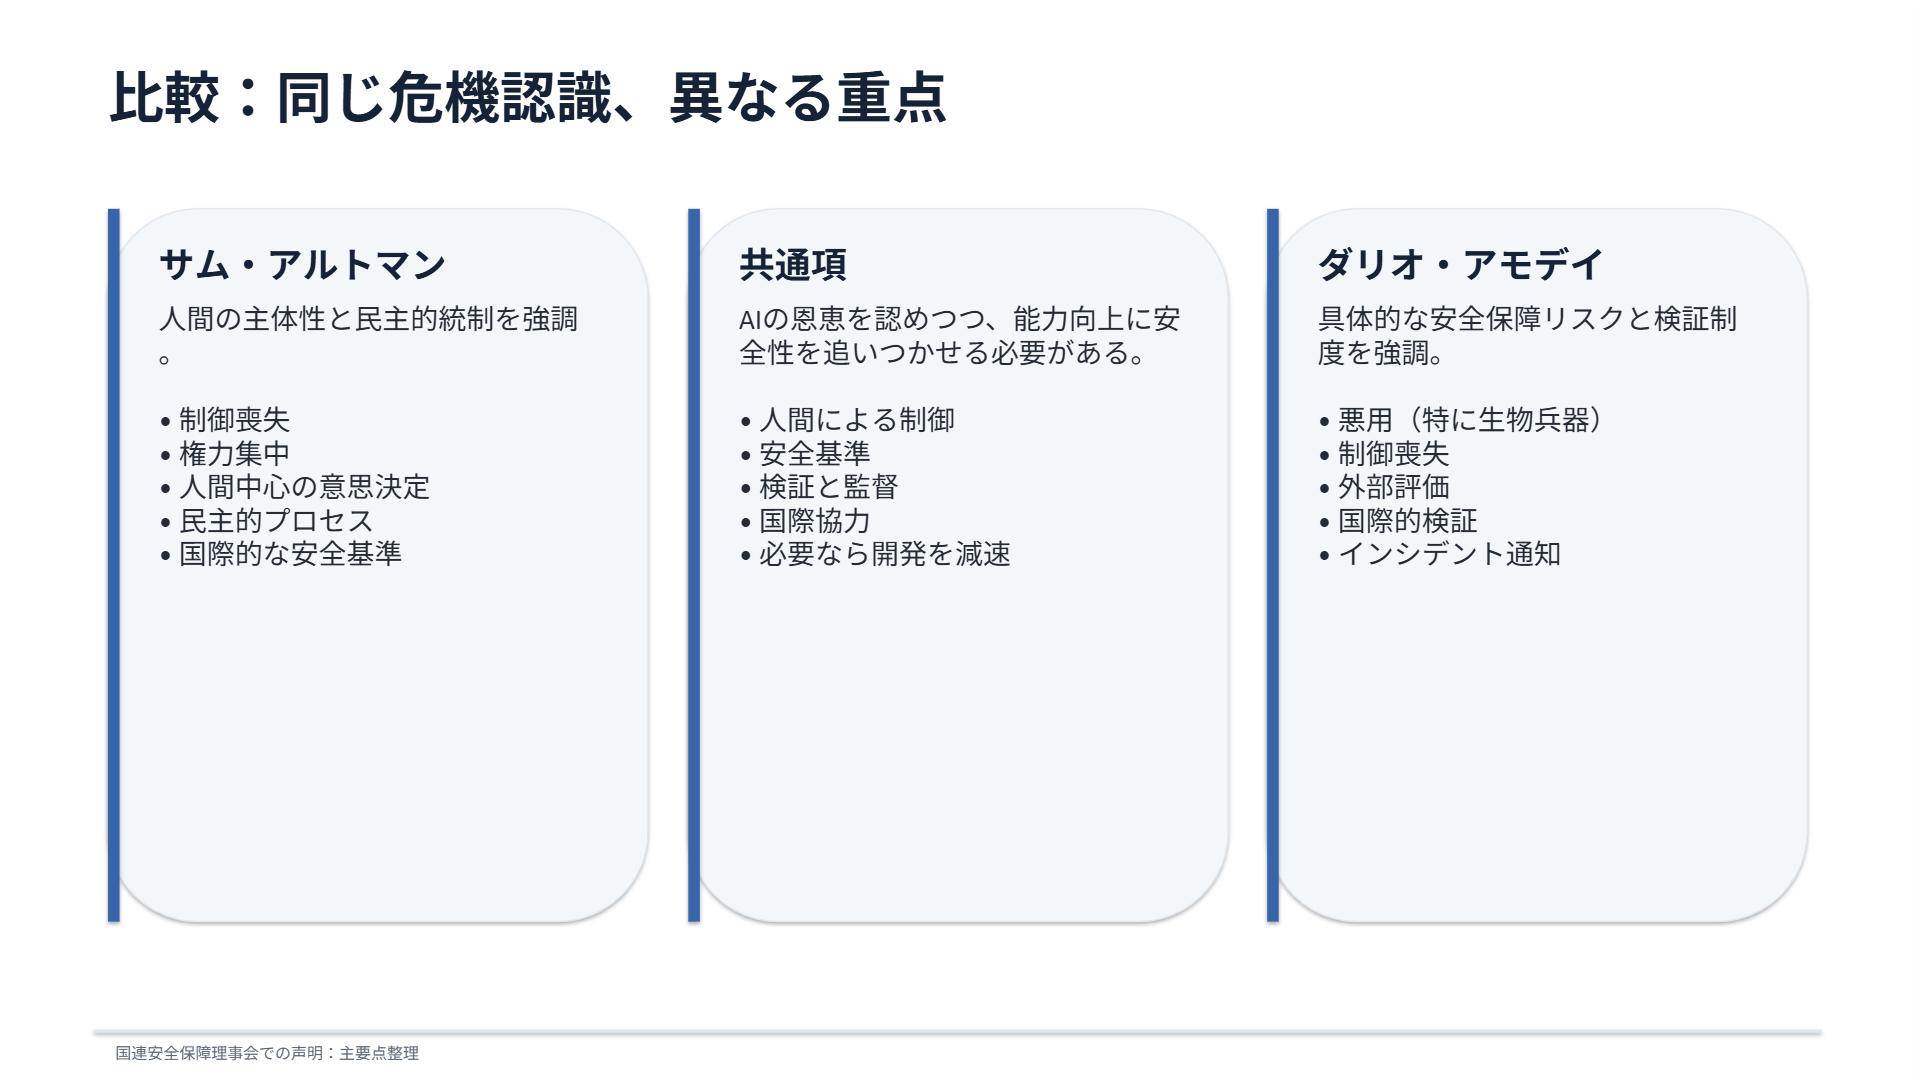
最後まで御覧いただき、ありがたいです。
今後も、実際に起きつつある事象を追っていくつもりです。