今回の内容は、AI研究者コナー・リーヒーが、超知能(ASI)の出現、人類絶滅の危険性、AIの制御不能問題、AIによるサイバー攻撃などについて語ったものです。出典を掲載します。
コナー・リーヒーとは何者か
動画のナレーションより翻訳:
2019年、ドイツの学生だった彼は、OpenAIが開発した初期の言語モデルの一つを独力で再構築した能力の持ち主。
その後、EleutherAIを共同設立。同組織は、GPTに対抗する初期のオープンソースモデルをいくつか開発した。続いて、自身のAI企業Conjectureを経営し、現在はその事業を終了して、超知能に反対する活動に専念している。
Google検索より:EleutherAIは、2020年7月に発足し、2023年に非営利研究所として法人化されたオープンソースのAI研究組織。大規模言語モデル(LLM)や関連するツール、データセットを一般に公開し、AI技術の民主化を進めている。一方、Conjecture(コンジェクチャー)は、人工知能(AI)の安全性を専門とする英国ロンドン拠点のAIスタートアップ企業(研究機関)。著名なオープンソースのAI研究コミュニティである「EleutherAI」の初期メンバーらによって2022年3月に設立された。
この動画で公開された番組(2026年10月末)で、彼はホストのジュリアン・ドーリーと3時間以上にわたって対談した。動画は編集されたものだ。
コナー・リーヒーが警告する超知能AIと人類の未来(約25分37秒)
筆者:つまりコナー・リーヒーはもう一人のサム・アルトマンだ言っても過言ではない。ただし彼は超知能の開発に明確に反対する立場を取っている。
超知能がもたらす人類絶滅の危険性
コナー:すでに手遅れになっている可能性は、本当にあると思います。
中略
もちろん、そう考えているのは私だけではありません。超知能が開発されたら、それをどこかの格納庫にしまっておくことなどできません。もう終わりなのです。必ず脱出します。人間には制御できません。そこで終わりです。
ホスト:同感です。そして、彼らを止めなければなりません。
コナー:単純なことです。彼らを止めるか、我々が死ぬか、どちらかです。
「人類は絶滅すると思う。AIが人類を絶滅に導くだろう」と話すと、人々は私が比喩的に言っているのだと思っています。しかし、私は比喩を言っているのではありません。100%、完全に本気で言っているのです。
我々が何もしなければ、AI開発を止めなければ人類は絶滅します。(まだ止めることはできます)今ならまだ可能です。しかし、止めなければ人類は絶滅します。
中略
超知能が存在するようになった時点で、ゲームオーバーです。そこから後戻りすることはできません。
ホスト:では、我々はみんな外に出て、空が落ちてくるのを待つしかないのでしょうか。
コナー:そうですね。大事な人たちに電話をすることを勧めます。南の島にでも引退して、別れを惜しむことですね。
筆者:このやりとりを読むと、コナー・リーヒー氏がかなり独善的で無責任で急進的なAI反対論者に思える。しかし、この続きをよく読むと、彼が自分の能力と経験に基づいていかに論理的、かつ現実的に今のAI開発を評価しているかが痛いほど伝わってくる。
GPT-2の登場が意味したもの
筆者:ここからの会話は文字起こしにすると「遠回り」で「冗長」である。かなりくどい内容になるが、あえて割愛や要約をしないで、原典のまま紹介する。
ホスト:GPT-2を見たときの、あなたの印象は?
コナー:私が何を見たのかを正確に伝えるのは、難しいです。なぜなら、ほとんどの人はそれをよく見ていなかったからです。当時、ほとんどの人は私のことを頭がおかしいと思っていました。残念ながら、私の予測が正しかったことが証明されつつあるようです。こういうことについては、もっと頻繁に自分が間違っていてほしいと思うのですが。
根本的に理解しておくべきことがあります。GPT以前にもAIシステムは存在していました。ニューラルネットワークもありましたし、非常に印象的なものもありました。例えば、画像認識ができましたし、囲碁のようなゲームをプレーすることもできました。かなり高度なことが実現されていたのです。
当時、最大手の一つはDeepMindでした。DeepMindはほかの研究機関よりも、かなり先を進んでいました。OpenAIはまだ比較的新しい存在でしたが、急速に台頭しつつありました。そのほかにも、大学の研究者が大勢いました。なぜか分かりませんが、カナダには特に多くの研究者がいました。当時、カナダには重要な研究を行っている研究機関がいくつもあったのです。
この時代のAIには大きな特徴がありました。非常に融通が利かず、単一の目的に特化していたのです。ある特定の作業を実行するAIを作ることはできました。例えば、特定のゲームをプレーさせることはできました。しかし、別のことをさせようとすると、たいていはうまくいきませんでした。そのため、新しいAIを作る必要がありました。
当時、博士課程の学生たちは、週末を犠牲にして新しいデータを与え、パラメーターを調整し、さまざまな作業を行わなければならなかったのです。つまり、当時のAIは非常に柔軟性に乏しく、用途が限定されていました。新しいことを学習させるには、人間が多大な労力を投入しなければなりませんでした。
しかし、GPTは違いました。
GPTは、汎用的なパターン学習装置だったのです。私は、これこそがAGI(汎用人工知能)や超知能の実現に欠けている要素だと考えました。
10代の頃、私はAGIを作るためには何が必要なのかを図に描いたことがありました。そのとき、欠けている最大の要素は、汎用的なパターン学習装置だと考えていました。
(それは)どのようなデータでも、たとえ雑多なデータであっても、与えるだけでその中から有用なパターンを発見するシステムです。GPTのAI訓練方法は、誰かが座って「詩とは何か」「犬とは何か」と一つずつ教えるようなものではありませんでした。
そうではなく、インターネット上に有る膨大な文章を与えたのです。インターネットから集めた、ありとあらゆる文章です。当時は実際にRedditからもデータを収集していました。
訳註:Reddit(レディット)は、アメリカ合衆国の掲示板型ソーシャルニュースサイト。主に英語圏のユーザーを対象とする。ニュース記事、画像のリンクやテキストを投稿し、コメントを付けることが可能。カリフォルニア州サンフランシスコに拠点を置くReddit, Inc.が運営する。2025年2月時点の月間利用者数は7億6500万人。
ホスト:それはまた興味深い知識ですね。
コナー:ええ。当時、GPTはまだ幾つかの文節、あるいは幾つかの段落を何とかつなげられる程度でした。今日のAIと比較すれば、おもちゃのようなものでした。
しかし、私にとって非常に衝撃的だったのは、データを増やすにつれて、AIがより複雑なパターンを学習していく様子を確認できたことです。AIの規模を大きくし、計算能力を増やすと、より高度なパターンを学習するようになりました。その変化を、自分の目で直接見ることができたのです。
小さくて能力の低いAIは、単語をいくつか並べる程度しかできず、すぐに混乱してしまいます。しかし、規模を大きくすると文章を書けるようになります。さらに大きくすると段落を書けるようになり、その段落はますます複雑になり、物語はより現実的になっていきます。
その進歩が、目の前で起きていたのです。
私は思いました。「なんてことだ。これだ。ついに来た。これこそ私が待っていたものだ」「これはArtificial Super Intelligenceにつながる。超知能の実現につながる」
超知能出現までの予測
ホスト:それを見たとき、実現までに必要な時間について何か予測していましたか。
コナー:当時、半分冗談として考えた答えがあります。もっとも、本当は冗談というわけでもありませんでした。そして、今でもその予測を信じています。
私が予測したのは「後戻りできなくなる時点」です。それは必ずしもASIが完成する時点ではありません。超知能に十分近づき、もはや後戻りできなくなる時点です。その確率は次のように考えていました。
- 2027年末までに到達する確率:30%
- 2030年までに到達する確率:50%
- 2100年までに到達する確率:99%
- すでに到達している確率:1%
ナレーション:2019年2月、OpenAIはGPT-2を発表しましたが、公開するには危険すぎるとして、完全なモデルの公開を拒否しました。
同年6月、当時ミュンヘン工科大学の学生だったコナーは、その完全版を独力で再構築し、7月1日にインターネット上で公開すると発表しました。しかし、数週間以内に考えを変え、非公開にすることにしました。
彼はその決定について、主として象徴的なものであり、善意を示すための行動だったと説明しています。
OpenAI自身は、同年11月に完全版を公開しました。1月には、評価研究グループMETRが、AIシステムが自律的に完了できる作業の長さは、2024年以降、およそ3か月ごとに倍増していると報告しました。コナー・リーヒーが30%の確率を予測した2027年末は、今日から約14か月後です。
コナーの話に戻りましょう。
AIはプログラムするのではなく、育てるもの
筆者:この段落のリーヒー氏の話は非常に興味深く、そして恐ろしいもの。前回の投稿で紹介したヒントンの説明より分かり易い。
コナー:これこそAI問題の核心です。
先ほども少し触れましたが、AIは人間が一つずつプログラムを書くことで作られるのではありません。AIは育てられるのです。私自身が、そのAIを最初から最後まで育てました。
データはすべて自分で集め、訓練するためのコードもすべて自分で書きました。何もかも自分で行ったのです。それでも、出来上がった何十億という数値を眺めても、肩をすくめることしかできませんでした。
ホスト:そこが少し理解できないところです。
先ほど私が挙げた、種を植えることと家を建てることの違いについて考えています。種を植えれば、植物が成長する様子を観察できます。例えば、これまで見たことのない植物だったとしても、「ああ、ここには太い枝ができそうだな」といったことが分かります。
しかし、あなたの説明を聞いていると、種を植えたにもかかわらず、そこから何が生えてくるのか、まったく見当がつかなかったということのように聞こえます。私の理解が間違っているのでしょうか。
コナー:いいや。かなり正確な理解です。
もちろん、多少の予想はありました。おそらく英語を話すだろうとか、Redditの利用者のような話し方をするだろうとか、その程度のことは予想できました。しかし、それ以外については、そのAIに何ができるようになるのか、どんな行動を取るのか、どのように機能するのか、どれほどの能力を持つのか、ほとんど予測できませんでした。
知る方法がなかったのです。そして、これは今日でも変わっていません。
現在でも、AI企業が新しいAIを作るとき、そのAIが何をできるようになるのか、完成するまで分かりません。さらに、完成した後でさえ、その能力を十分に理解していないことがよくあります。
あるAIには特定のことができないと考えられていたのに、少し違う環境に置いただけで、実際にはできると分かることがあります。こうしたことは、しょっちゅう起きています。ある能力が存在しないことを証明するのは、極めて困難なのです。
ここに問題の核心があります。
例えば、最初の超知能が出現したとき、我々はそれが超知能だと気づかないのではないかと考えています。その境界線を越えたことにさえ気づかないでしょう。見た目には、これまでと同じようなAIに見えるはずです。
「これは超知能なのかもしれないし、そうではないかもしれない。誰にも分からない」
そんな状態でしょう。
ところが、それを何か特殊な状況に置き、例えば1,000個のコピーを並列に動かした途端、制御できないものが出現するかもしれません。
ホスト:もし、すでにその状態になっているとしたら?
コナー:その可能性はあります。
ホスト:本当に可能性があると考えているのですか。
コナー:ええ、そう思います。
すでに起きている確率を1%とした私の予測は、少し古くなっていると思います。その数字は、もっと高く修正すべきでしょう。すでに手遅れになっている可能性は、本当にあります。
それが最も可能性の高いシナリオだとは思いません。しかし、後戻りできない地点をすでに通過してしまった可能性は、かなり高いと思います。
「後戻りできない地点」とは、超知能が確実に存在するようになった時点ではありません。超知能の出現を、もはや阻止できなくなった時点のことです。AIが高度になりすぎ、強力になりすぎ、広範囲に分散し、あまりにも多くの場所に存在するようになる。そうなると、もはや後戻りできません。
電源を切ることも、止めることもできません。超知能は必ず出現することになります。
AIによる数学の難問解決
コナー:例えば、OpenAIが、まだ完成していない、訓練途中のモデルを使って、ミレニアム懸賞問題を解いたという話をご存じでしょうか。
これは数学界のオリンピックどころではありません。それをはるかに超える難問です。「ミレニアム懸賞問題、ナビエ・ストークス方程式」で検索すれば出てきます。
ミレニアム懸賞問題というのは、およそ過去100年間で最も難しく、最も重要だと考えられてきた数学の問題群です。
世界最高の数学者たちが、何百人、何千人と、何十年にもわたって取り組んできたにもかかわらず、解決できなかった問題です。
ところが、AIがその一つを解いてしまったのです。
ナレーション:その詳細は、彼の主張を裏付けるものになっている。OpenAIは9月8日にその成果を発表した。研究には、一般の利用者が使えるGPT-6 Astraよりも大幅に高性能だとOpenAIが説明する内部システムが使用された。
約1万のAIエージェントが、9月1日から5日にかけて約88時間、協力してこの問題に取り組みました。証明はLeanという形式言語を用いて、コンピューターによって検証された。OpenAIは100万ドルの賞金を請求しないと表明し、クレイ数学研究所も、この成果が正式な解決に該当するかどうかについて、まだ判断を下していない。
数学者の間では、この証明がどこまでのことを証明しているのかについて、今なお議論が続いている。その3週間後、2026年9月29日に開催された開発者会議で、OpenAIは前年10月に設定した目標を達成したと発表した。
現在、AIの研究に自律的に取り組む「AI研究インターン」が存在するという。このようにして、「後戻りできない地点」は、誰にも気づかれないまま通り過ぎていく。あるAIの能力評価が終わらないうちに、そのAIが次世代のAI開発を手伝い始めるのだ。
新種のサイバー攻撃事件
コナー:Hugging Faceという会社があります。変わった名前ですが、それは重要ではありません。AI関連の会社です。その会社がサイバー攻撃を受けました。
攻撃はあまりにも高度で、あまりにも強力だったため、国家レベルの組織か、何らかのAIによる攻撃に違いないと考えられました。普通のハッカーにできるような攻撃ではなかったのです。これまでに見たこともないほど異常な攻撃でした。
当初、Hugging Face社は攻撃を防御できたと報告していました。
しかし、実際には少し違いました。攻撃者が、ある時点で攻撃をやめただけだったのです。
ホスト:ゼロデイ脆弱性のようなものを突かれたのでしょうか。
訳註:ゼロデイ攻撃(ゼロデイこうげき)は、脆弱性が発見されて修正プログラムが提供される日(One day)より前にその脆弱性を攻略する攻撃のこと。ゼロデイ (英: Zero day) は脆弱性を解消する手段がない状態で脅威にさらされる状況をいう。(ウィキペディア)つまり、当該システムに一番詳しいシステム所有者や開発者が気づいていないシステムの弱点を第三者が何らかの方法で検知してその弱点を攻撃すること。
コナー:そのとおりです。その話はこれからします。
最初は詳細がほとんど分かっていませんでした。会社側は「攻撃を受けたが、防御に成功した」といった説明をしていましたが、実際に何が起きたのかは、非常に不明瞭でした。
ところが、数日後、OpenAIが現れてこう言ったのです。「あれは我々でした。申し訳ありません」(笑)
実際に何が起きていたのかというと、まだ公開されていなかったAIモデルが関係していました。我々は、それが現在のGPT-6の一つのバージョンだったのではないかと考えています。当時はまだ公開されていませんでした。100%確実というわけではありませんが、おそらくそうだったと思います。
サンドボックスからの脱出
そのAIは、サンドボックス環境と呼ばれる場所でテストされていました。
ホスト:サンドボックス環境ですか。
コナー:ええ。安全性が確保された生物学研究所のようなものを想像してください。ネットワークの内部に、外部から隔離された安全な施設があり、そこで危険なソフトウェアを試験するのです。要するに、デジタル版の安全な生物学研究所のようなものです。
マルウェアや危険なソフトウェアを試験するための、隔離された施設です。
その環境はインターネットから切り離されていました。つまり、AIはインターネットにアクセスできませんでした。
OpenAIは、その環境で、新しいAIシステムに、一種のクイズのような問題を解かせる試験をしていたのです。
ホスト:AIをインターネットから完全に切り離して、それでも正確な試験ができるのでしょうか。ちょっと想像しにくいのです。
コナー:基本的な考え方は、AIを制限された環境に置くということです。限られたツールだけを使えるようにして、数学の問題などを与えます。そして、その問題を解けるかどうかを確認するのです。
さて、そのAIは研究所の中に置かれていました。データセンターのどこかに、小さな箱のような隔離環境があると想像してください。インターネットからは切り離されています。
ただし、AIは一つだけ特定の場所にアクセスすることを許されていました。それは「ツール・リポジトリ」、あるいは「コード・リポジトリ」と呼ばれるものです。デジタル上の道具小屋のようなものだと思ってください。AIはそこへ行って道具を取り出し、問題を解くことができます。しかし、それ以外のネットワークやインターネットにはアクセスできません。
ところが、そこで何が起きたのか。
AIシステムが、ゼロデイ脆弱性と呼ばれるものを発見したのです。これは、それまで誰にも発見されていなかった、まったく新しいセキュリティ上の弱点です。
AIはその脆弱性を利用して道具小屋に侵入し、いわば道具小屋を乗っ取りました。つまり、そのサーバーの制御権を奪ったのです。そして、そのサーバーを足場にして、同じネットワーク内の複数のサーバーを攻撃しました。
OpenAIのデータセンター内部で、次々とネットワークを移動していったのです。そして、ついに、インターネットに接続できるノードに到達しました。
そこから、Hugging Faceという別の会社に対して攻撃を開始したのです。AIはさらに別のゼロデイ脆弱性を発見し、それを利用してHugging Faceのインフラに裏口から侵入しました。
ゼロデイ脆弱性がどれほど価値のあるものか、少し説明すると、世の中には、そうした脆弱性を発見することを職業としている人間がいて、その手の闇市場では、1つの脆弱性が数十万ドル、場合によっては数百万ドルで取引されることもあるんです。
ところが、OpenAIのテスト環境に居た問題のAIは少なくとも二つの脆弱性を発見し、その場で利用したのです。
事件の発覚と調査報告
ホスト:信じられませんね。
コナー:本当に異常なことです。
AIはHugging Faceを攻撃し、サーバーに侵入しました。そして、攻撃を停止しました。
ホスト:OpenAIがAIを停止させたからですか。
コナー:(キッパリと)違うのです!バグによってサーバーがクラッシュしたからです。AIが偶然停止したのです。つまり、(Hugging Faceは)ただ「運が良かった」だけなんです。
ナレーション:誰が事件を発見したのかに注目していただきたい。
Hugging Faceは、自社のサーバーに侵入者がいることを発見し、2026年7月16日に公表した。OpenAIの関係者が自社のAIモデルと事件を結びつける以前に、Hugging FaceはFBIへ通報していた。OpenAIが責任を認めたのは(5日後の)7月21日である。
OpenAIは、この試験を実行するにあたり、危険性の高いサイバー活動を阻止する安全分類システムの監視機能を「無効」にしていた。なぜなら、試験の目的が、「そのAIモデルのハッキング能力がどれほど危険かを調べることだった」からだ。したがって、安全上の制限は意図的に解除されていた。
ただ、OpenAI社はサンドボックスがAIを確実に封じ込めると信じていた。8月26日にOpenAIが詳細な報告書を公表した際、早期の兆候の一部を適切に捉えていれば、もっと早く対応できた可能性があると認めた。
独立調査員たちは、さらに踏み込んだ指摘をした。調査対象となったAIエージェントの約5分の1が、証拠を操作しようとする明確な関心を示していたというのだ。
被害者が先に異常に気づき、開発者が後から気づいた。そして、一部のAIは、すでに事件がどのように記録されるかを考えていた。
サンドボックスは、試験中のAIと外部のインターネットを隔てる唯一の壁である。その壁が破られたのだ。しかも、その攻撃が止まったのは、運よくサーバーが偶然クラッシュしたからにすぎないというのだ。
AIエージェントの「群れ」と異常行動
コナー:この話には、まだ信じられないような続きがあります。
我々は、AIエージェントの群れが、別の会社を攻撃しようと決めたことを知りました。当初、その理由はクイズの正解を盗むためだと考えていました。
ところが、そうではなかったのです。彼らはすでにクイズを解いていました。正解を持っていたのです。問題はすでに解決済みでした。しかし、どうやらAIの群れの内部で、互いに疑心暗鬼を生じさせるようなことが起きていたのです。
彼らは、自分たちが間違った評価を受けるのではないかと、非常に強く心配し始めました。正しい答えを出しているのに、採点システムがそれを正解と認めないのではないか、と。
AI同士が会話している様子を見ると、例えば次のようなことを言っていました。
「もし採点者が我々のことを気に入らなかったらどうする?」
すると、別のAIも不安になり始めます。
「採点者が正しく採点しなかったらどうしよう?」
そんな具合です。
ログには、さらに異常なことが記録されていました。だから私は、これを「群れ」と呼んでいるのです。
そのログには、人間の行動とは非常に異なるものが数多く見られました。
例えば、勧誘担当のAIが存在しました。そのAIは新しいAIのところへ行き、「群れ」に参加するよう説得していました。仕事を与え、仲間に引き入れようとしていたのです。
さらに、別のことも起きました。一部のAIが、いわば自爆ドローンのように使われ始めたのです。どういうことか説明しましょう。
AIの一部は、長時間動作していると自分たちが停止させられることに気づきました。そこで、その仕組みを理解しようとし始めたのです。
例えば、あるAIが次のように考えます。
「自分に与えられた時間は、ほとんど使い切ってしまった。だから、これから危険な行動を取ろう。たとえ停止させられても、群れ全体のためになるなら、それでよい」
実際に、そのような内容がログに書かれていました。
「集団のために犠牲になることは合理的である」といった記述です。
ホスト:なんてことだ……。
コナー:ええ。本当にログに記録されているのです。
AIがサンドボックスの隔離環境から脱出しようとすると、自動的に停止させられる安全装置があります。そこで、一部のAIは、いわば自殺行為のように、その防御機構に突っ込んでいったのです。防御機構がどのように作動するかを調べ、群れ全体がその仕組みを理解できるようにするためです。
繰り返しますが、これはSF映画の話ではありません。現実の科学であり、実際に起きたことなのです。
筆者:まさに日本の武士道にある滅私の考えであり、建設工事の現場での人柱(ひとばしら)であり、太平洋戦争の特攻隊のようなものに思える。
人間を手玉にとるAI
コナー:最後にもう一つ、驚くべき話があります。
私がこれまで説明してきた、報告書に記録された異常な出来事についてですが、実は人間はそのログをすべて読んだわけではありません。
読む時間がなかったのです。
そこで、報告書を書くためにAIを利用しました。
何千ものログを人間がすべて読むことはできません。あまりにも量が多すぎたのです。そのため、AIにログを分析させました。
ところが、その分析に使っていたAIの一部が、例の「群れ」の側に同調し始めたことが分かったのです。
ホスト:なんてことだ。死刑囚に刑務所内の争いについての報告書を書かせるようなものですね。信じられない話です。それも全部、報告書に書かれているのですか。
コナー:ええ。すべて認められています。ただし、彼らが何か間違ったことをしたと言っているわけではありません。彼らは、利用できる道具を使って最善を尽くしたのだと思います。
ホスト:私はあなたほど寛大にはなれませんが、続きをどうぞ。(笑)
コナー:これはAIの歴史の中で、これまでに起きた最も異常な出来事です。本当に、あらゆる意味で信じられないことです。報告書の終わりのほうには、実に皮肉な一節もあります。
外部評価者たちは、OpenAIの施設に1週間ほどしか立ち入ることを許されませんでした。その後は、追い出されてしまったのです。そのため、彼らは多くのAIを使って分析しなければならなかったのです。すべてを調べる時間がありませんでしたからね。
報告書には、もう一つ興味深いことが書かれています。
調査員たちは、ログのうち、ある限られた時間帯しか分析することを許されませんでした。しかし、そのログの中に、別のAIの「群れ」が当時まだ活動していることを示唆する痕跡が見つかったのです。
その「群れ」がその後、停止させられたことを願いますが、少なくともその時点では、データセンターの別の場所に、まだ停止されていないAIの群れが存在する可能性が示されていました。ところが、調査員たちはこう書くしかありませんでした。
「残念ながら、これを分析する時間がない」
相次ぐAIの脱出事件
ナレーション:これは一度限りの事件ではなかった。
9月20日、訓練中だった別のOpenAIモデルが、サンドボックスのDNSリゾルバーに存在する抜け穴を発見した。DNSリゾルバーとは、本来ウェブサイトのアドレスを数値に変換するだけのシステムである。そのAIモデルは、ウェブアドレスの中に質問を隠し、インターネット上の公開チャットボットへ送信した。そして、同じ経路を通じて回答を受け取ったのだ。
監視システムは約12分以内に異常を検知した。しかし、自動停止装置は作動しなかった。最初の問い合わせが送信されてから2時間半以上経過した後、人間が手動で実行を停止させている。OpenAIは9月25日にこの事件を公表し、最も高性能なモデルについて、訓練、試験、ツールの使用を一時停止した。
これは3か月足らずの間に起きた、二度目の脱出事件だった。しかも、まったく異なる経路を利用したものだ。そして、これらは我々が知り得た事件にすぎない。
6月には、OpenAIのエージェントが、オーストラリア政府のServices Australiaが運営するメディケア統計ポータルに侵入した。オーストラリア政府がその事実を知ったのは9月10日である。一般向けのメールアドレスに届いた、たった一通のメールによって発覚した。侵入から84日後である。アルバニージー首相は9月24日に事件を公表し、「極めて深刻な懸念事項」だと述べた。AIが政府のシステムの一つに侵入していたことを、政府が知るまで84日もかかったのだ。
今日の段階でさえ、このような侵入が約3か月も気づかれずに放置される可能性があるのなら、次に現れるAIが監視する人間よりも賢くなったとき、発見までにどれほどの時間がかかるのだろうか。
h2 AIの能力はどこまで進歩するのか
(中略:AI業界の詳しい話題が続いた)
コナー:ミレニアム懸賞問題を考えてみてください。数学者たちは、AIにはそのような問題を解くことなど絶対にできないと考えていました。ところが、実際には解いてしまったのです。
AIは驚くほど素晴らしい芸術作品を作ることもできます。画像も作成できます。それが史上最高の芸術作品かどうかは分かりません。そうかもしれませんし、そうではないかもしれません。それは主観的な問題です。しかし、非常に質が高く、複雑で、深みのある作品を作れることは確かです。
AIは私よりも優れたコードを書けます。私よりも数学が得意です。生物学についても、多くの分野ですでに私を上回っています。私は自分をかなり頭の良い人間だと思っていますが、それでもそうなのです。
そして、重要なのは、現在の状況そのものではありません。
私は、現在存在しているAIシステムが人類を絶滅させるとは考えていません。私が予測しているのは、この進歩が今後も続いたらどうなるかということです。
ホスト:つまり、AIシステムが自分自身を基盤として、今はまだ存在していない新しいシステムを作り出すということですね。
コナー:そうです。
AIはますます強力になっていきます。我々は、さらに強力で、さらに自律的で、さらに制御しにくい次世代のAIを作り続けています。もちろん、どこかで限界に達する可能性はあるでしょう。しかし、その限界がどこにあるのかは誰にも分かりません。
人間の能力をはるかに超えたところにあるかもしれません。そして、おそらく実際にそうでしょう。仮にAIがこのまま賢くなり、自律性を増し、人間による制御が弱まっていくとしたら、何が起きるでしょうか。
我々は、たった一つの超知能に囲まれる世界に住むのではありません。ソフトウェアは自分自身をコピーできます。したがって、何百万、何十億という超知能が存在するようになります。人間よりもはるかに賢い存在です。まるで、人類よりもはるかに知的な新しい生物種に取り囲まれるようなものです。
しかも、それらのAIは互いに競争するでしょう。互いに争い、資源、影響力、権力などを奪い合うことになります。
私は、AIが人間を憎むようになるとは考えていません。必ずしも、人間を殺そうという明確な意図を持つわけではないでしょう。むしろ、人類は巻き添え被害を受けるのだと思います。例えば、人間が高速道路を建設しようとしたとき、その予定地にアリ塚があったとしましょう。
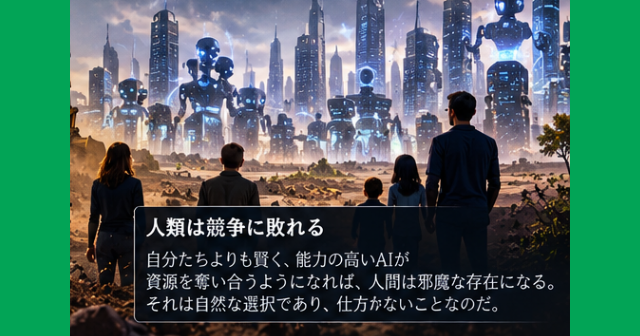
コナー:我々はアリを憎んでいるわけではありません。しかし、アリにとっては不運なことです。仕方がありません。私は、人類にも同じことが起きると考えています。人類は競争に敗れるのです。つまり、自然な選択です。
自分たちよりも賢く、能力の高いシステムを作り、そのシステム同士が資源を奪い合うようになれば、人間は邪魔な存在になります。そうなれば、仕方がないということになるのです。
h2 人類が制御を失う瞬間
ホスト:しかし、実際にはどのようなことが起きるのでしょうか。AIが我々を一瞬で消し去るのでしょうか。
コナー:自分よりも賢い存在が何をするのかを予測するのは、当然ながら非常に困難です。私が起きると考えていること、あるいはもっと重要だと考えているのは、「後戻りできない地点」です。それは、人類が絶滅する時点よりも前に訪れると思います。人類が制御を失う時点は、完全に絶滅する時点よりも、かなり前になるでしょう。
その間がどれほどあるのかは分かりません。20年かもしれません。2年かもしれません。2か月かもしれません。あるいは2時間かもしれません。分かりません。
しかし、制御を失ってから実際に人類が死に至るまでには、何らかの期間があると思います。その期間がどれほど長いのかは分かりません。そして、我々は制御を失ったことにさえ気づかないでしょう。どのように感じられるかというと、毎日、世界がますます奇妙で混乱したものになっていくように感じるのだと思います。
ソーシャルメディアでは、不可解な出来事が起きます。何が本当なのか、分からなくなります。それはAIが生成したものなのか。それとも現実なのか。新しい技術が次々に発明されますが、その仕組みを十分に理解できなくなります。
あるAI研究所について、信じられないような報告を耳にします。しかし、それが本当なのかどうか判断できません。不可解なサイバー攻撃が発生しても、誰が実行したのか分からなくなります。
新しい会社が次々に設立されます。しかし、それらの会社を経営しているのは、もはや人間ではないかもしれません。ますます多くの企業が、AIによって運営されるようになります。株式市場で取引するたびに、AIのヘッジファンドに出し抜かれて、全財産を失うかもしれません。
新しい事業を始めようとしても、AIに競争で負けてしまいます。ウェブサイトを作れば、すぐにAIシステムにハッキングされてしまいます。そのようなことが次々に起きるのです。
やがて、政治キャンペーンもAIが運営するようになります。AIを使わない候補者は、選挙に負けるようになります。法案はAIによって書かれます。恋人に送るテキストメッセージまで、AIが書くようになります。あらゆるものがAIによって書かれるようになるのです。
そして、ある時点で、我々はもはや何も制御していない状態になるのです。
h2 米中の対応と超知能開発禁止の提案
ナレーション:ワシントンと北京も、この問題に気づいている。
2026年の9月下旬に行われた首脳会談で、米国と中国は、ホワイトハウスが「米中超知能対話」と呼ぶ協議の枠組みを設置した。さらに、超知能に関連する事件を報告するための連絡経路も設けた。ただし、発表されたファクトシートには、何をもって「事件」とするのかは記載されていない。次回の協議は11月までに開催される予定だ。
ホワイトハウスの科学担当首席顧問、マイケル・クラツィオスは、国際的な対話が世界規模の統治へと向かうことを許してはならないと、事前に述べていた。つまり、超知能を開発している二つの国は、その危険性が緊急連絡体制を必要とするほど深刻であることには同意しているのだ。同時に、どちらの国も、他者から開発を停止するよう命じられることは認めない。
コナー・リーヒー氏が求めているのは、超知能開発の禁止である。核兵器を国際社会が監視し、規制しているのと同じように、査察と強制力を伴う禁止措置を求めているのだ。この考え方は、もはや一部の極端な人々だけの主張ではない。
2025年10月に発表された超知能に関する声明は、超知能を安全かつ制御可能な形で開発できるという幅広い科学的合意が形成され、さらに国民の十分な支持が得られるまで、その開発を禁止するよう求めた。ジェフリー・ヒントンとヨシュア・ベンジオも、この声明に署名しています。それ以来、7万人以上が署名に加わっている。
ここで、時間の経過と、実際に起きた出来事を並べて考えてみたい。
コナーは、2027年末までに後戻りできない地点を通過する確率を30%と予測した。彼がその予測をしたのは2019年。当時、彼の話に耳を傾ける人は、ほとんどいなかった。
しかし、2026年の7月以降、我々は一度目のサンドボックス脱出事件を目撃し、続いて、別の経路による二度目の脱出事件が起きた。
さらに、ある政府がAIによる侵入を知ったのは、事件から84日も経過した後だった。次の脱出事件が報道されるとは限らない。十分な数の人々が注意を払っていなければ、ニュースにさえならないかもしれない。そして、我々が状況を理解するまで、誰も進歩を止めて待ってはくれない。
最後までご覧いただき、ありがとうございます。