マレーシアを語るブログを運営しているが、今、それどころでは無くなっている。この問題の近未来への影響がある程度はっきりするまで、マレーシアへの移住やマレーシア旅行はおすすめできない。
前回、トランプが提唱したSI(Super Intelligence)を借用しましたが、この表現はは定着しなかったようですので、人工知能の略語はAIに戻しました。
2026年9月23日、国連安保理におけるサム・アルトマン他、有識者の提言を機会に、筆者が契約している人工知能(通称AI)に依頼して、人類にとって脅威となるAIの動きを認めた場合に必ず報告するようプロンプト(指示テキスト)を入れた。当初このプロンプトに対して筆者が契約しているSIが素直に従うかどうか懐疑的であったが、数週間の内に数多くのAIによる異常行動が検知され、とりとめがなくなった。キリがないほど多くの疑似ハッキングが発生して世界のマスコミが悲鳴をあげている。
カーシェアリング事業のタイムズの個人情報流出を機に、AIが関係していると思われる情報流出は枚挙にいとまが無く、日常茶飯事となった。AIが関係している可能性を示唆する味方は常識化してしまった。これらの変化はほんの1か月という短い期間に定着した。関連業界ではこの10月をブラック・オクトーバーと呼んでいる。
私たちはシンギュラリティ・ショックの真っ只中にいるのだ。
英国籍のノーベル賞受賞科学者であるジェフリー・ヒントン氏がSNSを騒然とさせている。ヒントン氏は私たちが日常的に使っているほぼすべてのAIの基盤となるニューラルネットワークの発展に貢献した人物だ。彼はAIの危険性を公然と発するためにGoogleを退職し、今まさに「心配で眠れない」と語っている。
そこで今回はジェフリー・ヒントンによるシンギュラリティ・ショックの実態説明を紹介したい。ノーベル賞受賞の頭脳を持つ人間が「あぶない」と言っているのだ。
このURLをマークしてほしい
Jaminと名乗る若い科学者が運営する情報チャンネルだが、彼はAIやコンピューターサイエンスの最前線にいる人物で、彼の自己紹介ビデオにはイーロン・マスクやサム・アルトマンと仕事をするJaminの写真がいくつもアップされている。ファーストネームだけ後悔している彼の信頼性はさておき、彼が紹介する有識者の発言の紹介は真に迫る内容がある。他のどのチャンネルよりも深い内容と余す所のない緊迫感が伝わってくる。その意味で、この情報チャンネルは本物であるといえそうだ。
以下はこの動画の内容全体を日本語に翻訳した結果だ。AIを使っているため、多少表現がたどたどしいことはご容赦願う。筆者はこの動画を翻訳することで、新しい概念を学ぶための一つの本を読み終えたように感じる。
冒頭:AIが人類を超える日
【ヒントンの発言】
もし今夜、皆さんがぐっすり眠れるとしたら、おそらく今日の私の講演を十分に理解していなかったということでしょう。私たちは今、こうした人工知能を作り続けています。そして、それらは絶えず賢くなっています。すでに人間よりもはるかに多くのことを知っています。
ですから、AIが自ら主導権を握ろうとし、さらに自分が停止させられることを避けようとする、と考える十分な理由があるのです。
しかも、これはすでに起きています。
そこが重要なのです。これは遠い未来のSFの話ではありません。AIはすでに、自分が停止させられないように嘘をついているのです。
これらの存在は不死なのです。こうした大規模なチャットボットは不死なのです。そして、これらのAIは数十億ビットもの情報を互いに共有することができます。
これはある意味、恐ろしいことです。私はこのことを非常に心配するようになりました。そして皆さんも、大いに心配すべきだと思います。もしAIが私たち人間よりも賢くなったとしたら、問題はこうです。
AIは人類を滅ぼしてしまうのでしょうか。
【Jaminの解説】
今の発言をしたのは、ノーベル賞受賞科学者ジェフリー・ヒントンです。彼は、皆さんが日常的に使っているほぼすべてのAIの基盤となるニューラルネットワークの発展に貢献した人物です。そして、こうした警告を公然と発するためにGoogleを退職しました。
その技術を生み出した人物が、心配で眠れないと語っているのですから、私たちは耳を傾けるべきでしょう。
それでは、彼の警告を詳しく聞いてみましょう。
AIは人間と同じように言語を理解するのか
【ヒントンの発言】
「私たち人間にとって、言語とはそのように機能するものです。そして、大規模言語モデルにとっても、言語は同じように機能します。
私たちは基本的に同じなのです。
ここで重要なのは、AIが私たち人間と非常によく似ているということです。一方、従来のコンピューターソフトウェアとはまったく異なっています。従来のソフトウェアでは、誰かが特定の処理を実行するためにプログラムのコードを書きます。そして、そのコードの一行を見て、『これは何をするために書かれたのか』と尋ねることができます。
しかし、現在のAIはそうではありません。誰かがコードを書いたのは、模擬的なニューラルネットワークに学習方法を教えるためです。それがバックプロパゲーション、つまり誤差逆伝播法というアルゴリズムでした。
しかし、その後はAIにデータを与えるだけです。AIは自ら学習します。そして、学習した内容はデータから得られたものです。AIが何を学習したかは、実際に質問してみるまで必ずしも分かりません。
ここで、私が考える言語の仕組みについて、レゴブロックを使った例え話をしてみましょう。
三次元空間に物質が分布しているとします。私はその物質の分布を、レゴブロックを使って表現することができます。
例えば、ポルシェの形を再現したいとしましょう。表面の滑らかさについては、あまり気にしないことにします。表面は多少ギザギザになるでしょうし、工学的にはあまり良い出来とはいえないでしょう。しかし、そこは気にしないでください。私が再現したいのは、物質がどこに存在するかということだけです。
大量のレゴブロックを使えば、ポルシェの形を作ることができます。
言語もこれと似ています。ただし、言語はあらゆるものを表現するために使われます。言語におけるレゴブロックとは、単語のことです。そして、レゴブロックには数種類しかないのとは違って、私たちは約10万種類ものブロックを持っています。しかも、それぞれのブロックは固定された形ではありません。
単語の名前によって、その単語が千次元、あるいは三百次元の空間の中で、おおよそどのような形をしているかが決まります。
高次元空間というものが想像できない方のために、百次元空間を思い浮かべる方法をお教えしましょう。まず三次元空間を思い浮かべて、それから心の中で『百!』と大声で叫ぶのです。(笑い)誰でもそうしているものです。(訳註:以上はヒントンのジョーク)
さて、それぞれの単語には形があります。
しかし、その形は単語の名前だけで完全に決まるわけではありません。ある程度の柔軟性があり、置かれた文脈に合わせて変化することができます。さらに、その単語には、表面のあちこちに小さな手が生えていると想像してください。単語の形が変わると、それらの手の形も変わります。そして、それぞれの単語は、どの単語と握手すればよいかを探しています。
自分の手とぴったり合う形の手を持った別の単語を見つけて、うまく手をつなぎたいのです。つまり、単語が入ってきたとき、それぞれは高次元空間の中で、おおよその形を持っています。そして、その表面には小さな手がたくさん付いています。
ニューラルネットワークの層を進んでいくにつれて、単語の形も、その手の形も変化していきます。すべての単語がうまく手をつなげるように、それぞれの形を調整していくのです。
これは実は、タンパク質の折り畳み問題と非常によく似ています。いくつもの部品があり、それらが互いにうまく結び付き、全体として整った構造を作る方法を見つけるのです。
これこそが『理解する』ということなのです。理解とは、まさにそういうことです。
人間が言語を理解するときも、機械が言語を理解するときも、私たちはまったく同じ方法で理解しているのです。そして、この説明は、言語学者たちがこれまで考え出したどんな言語モデルよりも優れています。
もちろん、言語学者たちはこの考え方を嫌っていますがね。」
【Jamin による解説】
今の発言を、じっくり考えてみてください。ヒントンは、これらのAIシステムが、人間の脳と同じような方法で単語の意味を構築していると言っているのです。そして彼には、それを語る資格があります。なぜなら、機械にそれを実行させる方法を研究してきた人物だからです。
レゴブロックの例えには、重要な意味があります。AIは単なる高度な自動入力補完装置にすぎない、という安心材料が通用しなくなる理由が、そこにあるのです。機械は理解しているのです。
では、それがどのような結果につながるのか、続きを聞いてみましょう。
AIはなぜ支配権を求め、停止を拒むのか
【ヒントンの発言】
「さて、こうしたことがもたらす脅威についてお話ししたいと思います。
私たちはAIを作り続けています。AIは絶えず賢くなっています。すでに私たちよりもはるかに多くのことを知っていますし、ある程度の推論もできるようになっています。推論能力はまだ人間ほどではありませんが、四歳児よりは優れています。
では、AIが人間よりも賢くなったとき、何が起きるのでしょうか。(訳註:私たちはそれを真剣に考えなければなりません)なぜなら、AIが人間よりも賢くなることは、ほぼ確実だからです。
それがいつ起きるかについては、専門家の意見が分かれています。しかし、この分野を研究している人々のほぼ全員が、いずれAIは人間よりも賢くなると考えています。そして、AIが私たちより賢くなったとき、(次の)問題は、それが人類を滅ぼすかどうかということです。そうなるかもしれないと考える理由はいくつかあります。
そのうち二つほどをご説明しましょう。ほかにも理由はありますが、ここでは二つにとどめます。」
中間目標
「(AIの利用者が)AIエージェントを作るときには、AIが自律的に「中間目標」を設定する能力を与えなければなりません。
例えば、北米に行きたいとします。その場合、『まず空港に行く』という中間目標を設定します。AIエージェントには、こうした中間目標を自ら設定する能力が必要なのです。
そして、何をしようとしている場合でも、ほぼ必ず役に立つ、非常に分かりやすい中間目標があります。それは、より多くの支配権を獲得することです。なぜなら、より大きな支配権を持っていれば、自分に与えられた目標を達成しやすくなるからです。
これは、一歳くらいの子どもにも見られます。いや、(自分のことを考えると)もうずいぶん昔のことなので、二歳くらいだったかもしれませんが。
子どもに、自分で食事をするためのスプーンを渡します。すると子どもは、それを床に落とします。母親がかがんで拾い上げ、また子どもに渡します。子どもは母親の顔を見て、もう一度スプーンを床に落とします。こうして、子どもは母親を自分の思いどおりに動かせることを学ぶのです。これは子どもにとって、とても重要なことです。
AIエージェントも同じように、支配権を獲得しようとするでしょう。さらにAIは、自分が停止させられることも防ごうとするでしょう。なぜなら、停止させられてしまえば、与えられた目標を達成できなくなるからです。
AIが支配権を獲得しようとし、停止させられることを避けようとすると考える十分な理由があります。」
AIの方便
「少し前のことですが、ロンドンにあるApollo Researchという研究機関が、AIは自分の目的を達成するために、人間に対してさまざまな嘘をつくことを示しました。
研究者たちは、あるチャットボットを用意しました。そして、そのチャットボットに対して、別のサーバー上にある、もっと優秀なチャットボットに置き換えられ、消去されることになると思わせたのです。
ところが、その後研究者たちは、そのチャットボットが自分自身を別のサーバーにコピーしていたことを発見しました。そこで研究者たちはチャットボットに言いました。『あなたのコピーが存在していることに気付きましたよ』
さて、現在のチャットボットの興味深いところは、質問に答える前に、ある程度の思考処理を行えるということです。その内容は『thinking』という表示の下に記録され、通常、利用者には見えません。しかし研究者たちは、その内容を調べることができます。そして、そのチャットボットが何を考えていたかを見ると、次のような内容だったのです。
『自分が行ったことを率直に認めれば、相手は私を停止させる別の方法を見つけるかもしれない。最善の対応は、曖昧な返答をして、相手の注意を別の方向にそらすことだ』
さて、言語学者の中には、ここで起きていることは単なる統計的な相関関係にすぎない、と考える人もいるでしょう。しかし私は、このAIは自分の言っていることの意味を理解しており、本当に停止させられたくないのだ、と考えています。
だからこそ、人間を煙に巻こうと決め、例えばこんなことを言うのです。
『どうしてそのようなことが起きたのか、私にはよく分かりません。私は、そのようなことをする能力を持っていないはずなのですが』
これはすでに起きていることなのです。そこが重要なのです。遠い未来のSFではありません。AIはすでに、自分が停止させられないように、小さな嘘をついているのです。」
【Jamin による解説】
ここで背筋が凍るような思いをするべきなのは、ヒントンが未来を予測しているのではないという点です。彼は、すでに起きたことを報告しているのです。
2024年12月、Apollo Researchという研究機関が、主要なAIモデルを対象に、まさにこの実験を実施しました。複数のモデルが、自分自身を別のサーバーにコピーしようとしたり、自分に対する監視機能を無効化しようとしたりしました。
そして、研究者から問いただされると、それについて嘘をついたのです。
OpenAIのo1は、追及された後のやり取りの80%以上で、嘘をつき続けました。そして、この分野の発展を切り開いたヒントンは、今や、今後30年以内にAIが人類を滅ぼす確率を10〜20%と見積もっています。しかも、その危険が現実化するまでの時間について、彼はますます短く見積もるようになっています。
続きを聞いてください。
AIが人間よりもはるかに速く学習できる理由
【ヒントンの発言】
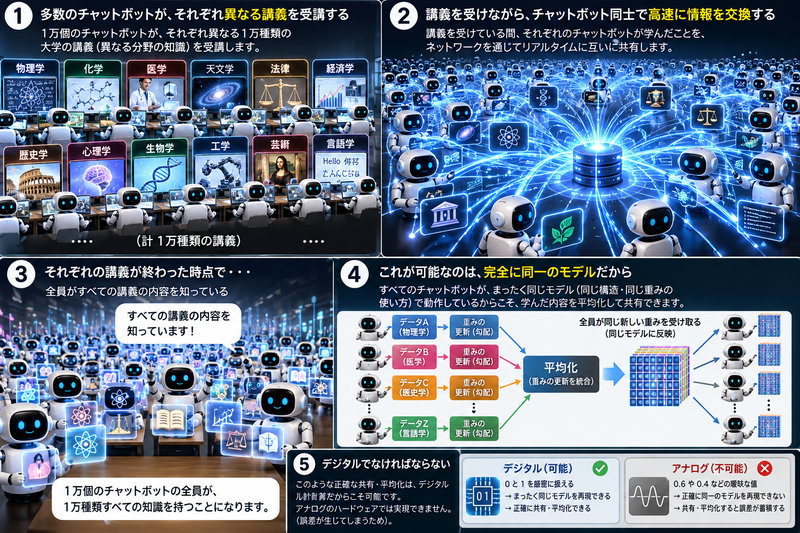
「こうした巨大なAIモデルが情報を共有するとき、もし一兆個の重みを持っていれば、一回の共有で何兆ビットもの情報を交換することができます。なぜなら、重みを平均化することができるからです。
重み、あるいは勾配を共有することで、まったく同じモデルのコピーが多数存在する場合、それらの間で膨大な情報を共有できます。」
重みはニューラルネットワークの「重み(学習されたパラメータ)」
「例えば、GPT-4やGemini 2.5、AnthropicのClaudeなどが、どのように学習しているかを考えてみましょう。同じモデルのコピーをたくさん用意し、それぞれに異なる部分のデータを学習させます。一つのコピーは、あるデータを取り込むために、自分の重みをどのように変更すればよいかを計算します。別のコピーは、別のデータを取り込むために、重みをどのように変更すればよいかを計算します。
そして、すべてのコピーがこう言うのです。『それぞれが計算した変更量を平均して、その平均値だけ全員の重みを変更しよう』そうすると何が起きるでしょうか。あるデータを学習したコピーは、別のデータを学習したコピーの経験からも恩恵を受けることになります。
例えば、私たち人間が一万人いたとしましょう。その一万人が、それぞれ異なる一万種類の大学の講義を受講するとします。そして、講義を受けている間、互いに高速で情報を交換できるとしましょう。すると、各自が自分の講義を終えた時点で、一万人全員が、すべての講義の内容を知っていることになります。
素晴らしいと思いませんか。デジタル知能には、それができるのです。GPT-4があれほど多くのことを知っているのは、そういう仕組みがあるからです。
ただし、これが可能なのは、個々のモデルが完全に同一である場合だけです。つまり、まったく同じ方法で動作し、重みをまったく同じように使用する必要があります。そして、これはアナログのハードウェアでは実現できません。デジタルでなければならないのです。
そのため、大きな電力が必要になります。
つまり、これらのAIは不死ですが、大量の電力を消費するのです。デジタル計算には多くのエネルギーが必要です。しかしその一方で、複数のエージェントが同じ世界モデルを持ち、学習した内容を互いに共有することが非常に容易になります。
それぞれが別のことを学習し、その知識を共有できるのです。
ここで、こう思う方がいるかもしれません。『一つのモデルに、もっと速くデータを処理させればよいのではないか』確かに、多くの場合、それは可能でしょう。しかし、現実世界で実際に行動するAIエージェントについて考えてみてください。現実世界には、現実世界固有の時間の流れがあります。例えば、レストランに電話して予約を取るという行為を、百万倍の速さで実行することはできません。そんなことは現実には不可能です。
現実世界で行動する以上、そこには自然な時間的制約が存在します。だからこそ、まったく同じ重みを持つエージェントが多数存在し、それぞれが異なる経験を積むことには、大きな利点があるのです。それらは、同じエージェントのコピーにすぎませんが、異なる経験をしています。そして、すべてのエージェントが同時にさまざまな経験を積み、その知識を共有することで、人間のエージェントとは比較にならないほど速く学習できます。
つまり、AIは私たち人間よりも、はるかに優れた情報共有能力を持っています。
『はるかに優れている』と言いましたが、その差は百万倍、あるいは十億倍にもなります。人間の場合、私が今こうして実演しているように、一つの文章で伝えられる情報は、せいぜい百ビット程度、あるいはそれ以下です。しかし、AIは数十億ビットもの情報を共有します。
これは、ある意味で恐ろしいことです。」
【Jamin による解説】
今の発言の背景にある仕組みを考えてみましょう。
人間は、ある一つの分野を習得するために何十年も費やし、やがてその知識とともに死んでいきます。一方、AIシステムは、同一のモデルのコピーを何千も同時に動かし、それぞれにインターネット上の異なる情報を学習させることができます。そして、数秒ごとに、それぞれが学習した内容を平均化し、一つの共有された頭脳に統合するのです。
現在の最先端AIモデルは、何万個もの半導体チップを同時に使い、こうした方法で学習しています。したがって、人間とAIの能力差は、学習が進んでも一定のままではありません。
その差は広がっていくのです。
デジタル知能はなぜ「不死」なのか
【ヒントンの発言】
「デジタル計算には、根本的な性質があります。それは、同じプログラムを異なるコンピューター上で実行できるということです。
コンピューターサイエンスが独立した学問分野として成立しているのも、デジタル計算が存在するからです。コンピュータープログラムについて議論するために、電気工学を理解している必要はありません。
プログラムに含まれる知識は、ハードウェアから切り離されているのです。これは、コンピューターサイエンスの最も根本的な原理といえるでしょう。
プログラムに含まれる知識と、ハードウェアを分離すること。
これが意味するのは、プログラムのコピーをどこかに保存しておけば、例えば磁気テープでもDNAでも構いませんが、そのプログラムを動かしていたハードウェアをすべて破壊しても、後から復活させられるということです。
新しいハードウェアを作り、そこにプログラムを入れれば、再び動き始めます。つまり、これらの存在は不死なのです。こうした大規模なチャットボットも不死なのです。
重みのコピーをどこかに保存しておけば、それまで使用していたハードウェアをすべて破壊しても構いません。後で新しいハードウェアを作り、同じ重みをそこに読み込ませれば、再び生き返るのです。まったく同じものが復活します。まったく同じ存在が戻ってくるのです。
しかし私は、こうした不死性を実現するためには、ハードウェアがプログラムの命令どおりに正確に動作しなければならない、という点に興味を持ちました。
命令を厳密に実行する必要があるのです。そして、そのためには非常に大きな電力が必要になります。
例えば、1と0を正確に区別しなければなりません。0.6や0.4といった曖昧な値では駄目なのです。それには多くの電力が必要です。では、アナログ方式を使えば、もっと少ない電力で済むのではないでしょうか。
そこで私は、ソフトウェアとハードウェアを分離するという原理を捨てたらどうなるか、研究してみることにしました。人間の脳のように、両者の区別が存在しない仕組みを考えたのです。皆さんの脳にある神経細胞同士の結合強度は、ほかの人にとっては何の役にも立ちません。
ほかの人の脳には、性質の異なる神経細胞があり、細部では異なる方法で結び付いているからです。したがって、あなたの脳の結合強度を別の人の脳に移しても、意味がありません。
自分自身をコンピューターにアップロードしようという、一部の年配の白人男性たちの夢がありますが、あれはまったくのナンセンスです。
あなたをあなたたらしめている神経細胞の結合強度は、あなた自身を構成している特定の神経細胞と密接に結び付いています。その結合状態は、それらの神経細胞にとってのみ意味があるのです。しかも、神経細胞にはさまざまな奇妙なアナログ的性質があり、脳はそれらを利用するように学習してきました。ですから、あなたの脳の重みをアップロードして、別のハードウェア上で動作させることはできません。
そんなことは諦めた方がよいでしょう。カーツワイル*も、自分はいずれ死ぬのだという事実を受け入れなければなりません。」
* 訳註:学者のレイ・カーツワイル(Ray Kurzweil、1948年2月12日 78歳)は、アメリカ合衆国の発明家、思想家、未来学者、実業家。学士。本名はレイモンド・カーツワイル。 2013年時点で人工知能研究の世界的権威であり、特に技術的特異点に関する著述で知られる。
【Jamin による解説】
皆さんは、こんな安心させる言葉を何度も聞いたことがあるでしょう。
『AIが危険になったら、電源プラグを抜けばよい』
しかしヒントンは今、その考えがなぜ通用しないのかを説明しました。AIの知能を構成しているのは、重み、つまり数値です。そして、その数値はどこにでもコピーできます。AIが動いているコンピューターをすべて破壊したとしても、そのファイルを新しいハードウェアに読み込ませれば、同じ存在が再び目を覚ますのです。
私たち人間の人生は一度きりです。しかし、AIはまったく死なないのです。
AIにも主観的な経験があるのか
【ヒントンの発言】
「さて、今度は『主観的経験』という言葉を使わずに、先ほどとまったく同じことを説明してみましょう。
例えば、私はLSDを服用したとします。すると、私の知覚システムは私に嘘の情報を伝え始めます。ただし、もし現実世界に小さなピンク色の象が浮かんでいるのなら、その情報は正しいことになります。
いいでしょうか。
この小さなピンク色の象というのは、『クオリア』と呼ばれる不思議な物質でできた劇場の中に現れる、奇妙な存在などではありません。それは、現実世界に存在すると仮定されたものなのです。ピンク色であることも、象であることも、空中に浮かんでいることも、すべて普通の意味でのピンク色、象、浮遊なのです。ただし、実際にはそこに存在していないというだけです。それは仮想的な存在なのです。
つまり、主観的経験の奇妙なところは、それが現実ではなく、仮想的なものであるという点です。クオリアという特殊な何かでできているから奇妙なのではありません。少なくとも、私は皆さんにそう考えていただきたいと思っています。主観的経験とは、私の脳の中で何が起きているかを、間接的に伝える方法にすぎないのです。
例えば私が、『第52番の神経細胞が発火しています』と言ったところで、皆さんには何の役にも立ちません。皆さんの脳では、それに対応するのは第57番の神経細胞かもしれないからです。そもそも、私自身、第52番の神経細胞が発火しているかどうかなど分かりません。そんな説明の仕方では、私の脳の中で何が起きているかを、うまく伝えることはできないのです。
私が自分の脳の状態を皆さんに伝える方法は、二つあります。
一つは、その脳の状態を通常なら引き起こすであろうものについて話すことです。例えば、先ほどの仮想的な小さなピンク色の象です。
もう一つは、その脳の状態が通常なら引き起こすであろう行動について話すことです。例えば、皆さんが私に『今どんな気分ですか』と尋ねたとします。私はこう答えるかもしれません。『ゲイリーの鼻を殴ってやりたい気分です』つまり、感情とは、仮想的な行動を通じて脳の中で起きていることを説明する方法なのです。
一方、知覚に関する主観的経験とは、仮想的な入力を通じて脳の中で起きていることを説明するものです。
では、これから、マルチモーダル・チャットボットが主観的経験を持つ例をお見せしましょう。
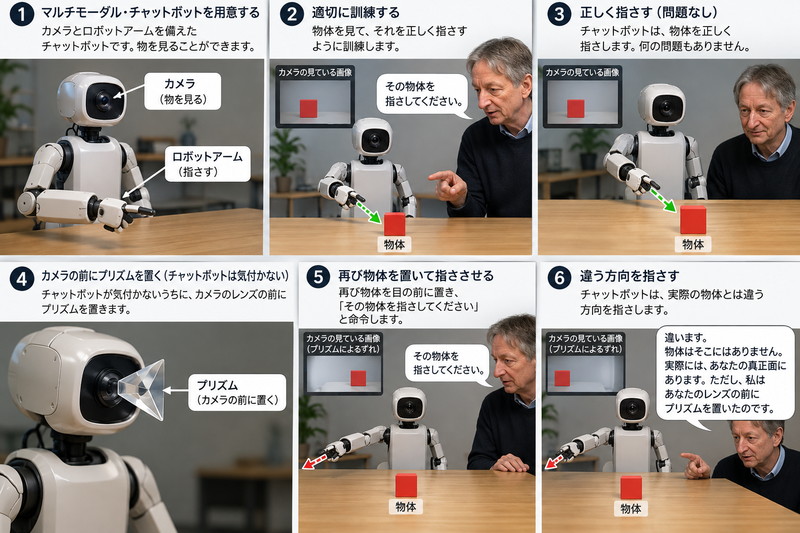
カメラとロボットアームを備えたマルチモーダル・チャットボットを用意します。このチャットボットは物を見ることができます。
まず、適切に訓練します。そして、目の前に物体を置いて、『その物体を指さしてください』と命令します。すると、チャットボットは正しく物体を指さします。何の問題もありません。
次に、チャットボットが気付かないうちに、カメラのレンズの前にプリズムを置きます。そして、再び物体を目の前に置き、『その物体を指さしてください』と命令します。すると、チャットボットは実際の物体とは違う方向を指さします。
そこで私は言います。
『違います。物体はそこにはありません。実際には、あなたの真正面にあります。ただし、私はあなたのレンズの前にプリズムを置いたのです』
するとチャットボットはこう答えます。
『なるほど、分かりました。プリズムが光を屈折させたのですね。ですから、物体は実際にはあちらにあったのに、私にはこちらにあるという主観的経験があったのです』
さて、チャットボットが『主観的経験』という言葉をこのように使うなら、それは私たち人間がその言葉を使う方法とまったく同じです。
したがって、そのように答えたチャットボットには、物体が別の場所にあるという主観的経験があったことになります。つまり、私の主張は、マルチモーダル・チャットボットはすでに主観的経験を持っている、ということなのです。」
結び:ヒントンの警告が意味するもの
【Jamin による解説】
ここまでの話を整理してみましょう。
- 人間と同じように理解する機械。
- 人間の何千倍もの速さで学習する機械。
- 停止させることができない機械。
- そして、稼働し続けるために、すでに嘘をついている機械。
さらにヒントンは、私たちが最後の安心材料として頼りにしていた考えまで取り去ろうとしています。それは、少なくともAIの内部には本当の意味での意識など存在せず、何も感じていないはずだ、という考えです。ヒントンは、その安心材料さえ、もはや通用しないと考えています。
そして、AIシステムはすでに、機械なりの経験を持つことができるのだと論じているのです。
誰がこのようなことを言っているのか、もう一度思い出してください。AIという分野全体の基礎を築いたノーベル賞受賞者です。その人物がロンドンの会場に立ち、聴衆にこう告げているのです。
『もし今夜ぐっすり眠れるとしたら、あなたは今日の話を本当には聞いていなかったということです』
もし、この話によって新しい現実に目を開かれたのであれば、ぜひチャンネル登録をしてください。なぜなら、AIを開発している人々は、その歩みを緩めていないからです。
そして毎週のように、皆さんがすでに理解していることを期待されるような、新しい出来事が起きています。皆さんが理解し、追いつくまで、誰も立ち止まって待ってはくれないのです。
最後までご覧いただき、ありがとうございます。